3 · La cadena DDC
Qué hace y por qué
El ADC entrega el IF real muestreado a fs: en la ZU9, una señal centrada en 60 MHz muestreada a
250 MHz. Lo que el DSP necesita son muestras complejas en banda base, una por celda de rango, a
una tasa mil veces menor.
Esa conversión es el digital down-converter, y son cuatro pasos:
graph LR
    ADC["IF real<br/>16 bits @ fs"] --> MIX["mezclador<br/>complejo"]
    NCO["NCO<br/>cos/sin"] --> MIX
    MIX --> CIC["CIC<br/>N=5, R=52"]
    CIC --> FIR["FIR<br/>droop + ÷4"]
    FIR --> HB["÷2 semibanda<br/>(solo modo grueso)"]
    HB --> GATE["gating<br/>bins + TLAST"]
    FIR --> GATE
Los factores: 52 × 4 = 208 en modo fino, ×2 más = 416 en modo grueso. Que R₂ sea exactamente 2·R₁ no es casualidad: es lo que permite una sola cadena con una etapa conmutable en vez de dos cadenas independientes, y es media D-04.
El modelo entero está en model/drx_model/, es el oráculo, y esta página lo recorre bloque a bloque.
Paso 1 — el NCO
Un oscilador controlado numéricamente es un acumulador de fase más una tabla. Cada muestra se suma un incremento fijo a un acumulador de 32 bits; los bits altos del acumulador direccionan una LUT de seno y coseno.
def generate(self, n: int, initial: int = 0):
    """`(cos, sin)` cuantizados, con truncamiento de fase a la LUT."""
    shift = self.phase_bits - self.lut_addr_bits
    addr = self.phase(n, initial) >> shift
    cos_lut, sin_lut = self.lut()
    return cos_lut[addr], sin_lut[addr]
El incremento sale de la frecuencia normalizada, y por eso es invariante entre plataformas:
Qué cuesta truncar la fase
El acumulador tiene 32 bits pero la LUT solo se direcciona con 16. Los 16 bits que se tiran son un error de fase determinista y periódico, y un error periódico en fase produce rayas espectrales, no ruido. Es el modo de truncamiento de fase del DDS Compiler, y el modelo lo reproduce porque si no, la comparación bit a bit contra la IP no cerraría.
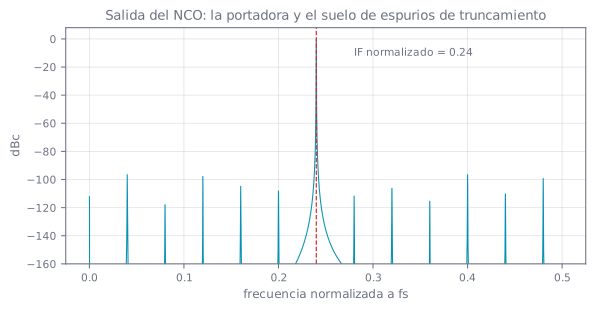
La portadora está donde tiene que estar, en 0,24 de fs. El peor espurio medido está a −86,4 dBc.
Para un receptor de 16 bits —cuyo suelo de cuantización teórico está en torno a −98 dBFS— es un
número que hay que mirar, y es exactamente la clase de cosa que se decide en Z1 al configurar la IP:
más bits de LUT, o dithering de fase, cuestan recursos y compran espurios.
Lo que el modelo garantiza hoy es que ese suelo es reproducible y está medido, no que sea el definitivo.
def test_nco_emite_en_la_frecuencia_normalizada_del_if():
    nco = Nco.from_params(PARAMS)
    cos_w, sin_w = nco.generate(8192)
    spectrum = np.abs(np.fft.rfft(cos_w.astype(np.float64) - np.mean(cos_w)))
    peak_norm = np.argmax(spectrum) / 8192
    assert peak_norm == pytest.approx(float(PARAMS.if_norm), abs=1.0 / 8192)
Paso 2 — el mezclador
Multiplicar la señal real por coseno y por seno la baja a banda base y la convierte en compleja:
El signo de q no es arbitrario ni una elección de libro de texto: es la convención de cuadratura
que de verdad entrega el DDS Compiler de Xilinx (e^{+j\omega n}, no e^{-j\omega n}), confirmada
bit a bit contra xsim en Z1 — ver P-10. El modelo se ajustó para
coincidir con la IP real, no al revés.
En enteros, el producto de 16×16 bits crece a 32 y hay que volver a bajarlo quitando el fondo de escala del NCO:
def mix(self, x):
    cos_w, sin_w = self.nco.generate(x.size)
    shift = self.params.invariant["nco_out_bits"] - 1
    i = fixed.shift_round(x * cos_w, shift)
    q = fixed.shift_round(x * sin_w, shift)
    return i, q
El desplazamiento es 15, no 16, porque el fondo de escala positivo de 16 bits es 2¹⁵−1. Y es
shift_round, no shift_truncate, por lo que vimos en la página anterior.
Producto de un tono por un coseno de la misma frecuencia: aparece un término en continua y otro al doble de frecuencia. El primero es la señal; el segundo lo tiene que matar el filtro que viene ahora.
Paso 3 — el CIC
Un filtro CIC es la forma barata de diezmar mucho: no tiene multiplicadores. Son N integradores a la tasa alta, un diezmado, y N peines a la tasa baja.
# Integradores. `cumsum` sobre int64 envuelve módulo 2**64, y como 2**bits
# divide a 2**64, los `bits` bits bajos son los correctos: es la misma
# aritmética que el registro del hardware.
for _ in range(self.stages):
    acc = fixed.wrap(np.cumsum(acc), bits)

acc = acc[self.rate - 1 :: self.rate]        # diezmado

delay = self.diff_delay
for _ in range(self.stages):
    delayed = np.concatenate([np.zeros(delay, dtype=np.int64), acc[:-delay]])
    acc = fixed.wrap(acc - delayed, bits)
El truco que hay que entender
Un integrador puro es inestable: acumula sin límite y desborda. En un CIC eso es correcto, y es el resultado de Hogenauer: el desbordamiento de los integradores se cancela exactamente en los peines siempre que todos los registros tengan al menos
bits. Con N=5, R=52, M=1 y 16 bits de entrada:
CIC gain 380204032 growth 29 reg 45
380 204 032 = 52⁵, 29 bits de crecimiento, 45 bits de registro. Ese es el número que determina cuántos DSP48 y cuánta lógica cuesta el CIC en la FPGA, y sale de una fórmula, no de una estimación.
Es también la razón por la que el modelo usa wrap y no precisión infinita: un modelo con enteros
grandes de Python daría otro resultado en los transitorios y la comparación bit a bit contra el
CIC Compiler fallaría sin que hubiera ningún bug.
def test_ganancia_en_continua_del_cic():
    """(R·M)^N exacta: cualquier otra cosa es un error de escalado."""
    cic = _cic()
    steady = cic.process(np.full(cic.rate * 20, 1, dtype=np.int64))
    assert steady[-1] == cic.gain == cic.rate**cic.stages
El precio: el droop
El CIC no es un filtro plano. Su respuesta es
que cae monótonamente dentro de la banda de paso. En el borde de banda útil la caída medida es −0,580 dB. Eso deforma el espectro de la señal y hay que corregirlo.
Paso 4 — el FIR, que hace dos trabajos
El FIR Compiler hace a la vez:
- Compensar el droop: su respuesta en banda de paso es aproximadamente el inverso de la del CIC.
- Antialiasar el diezmado ÷4 que viene después.
Los coeficientes se diseñan con
scipy.signal.firwin2
—muestreo en frecuencia, que admite una respuesta deseada arbitraria, justo lo que hace falta para
invertir una curva— y se congelan en config/coeffs/:
# Banda de paso: el inverso del droop del CIC. La frecuencia del CIC está
# normalizada a fs, así que hay que dividir por su factor de diezmado.
passband = grid <= PASSBAND_EDGE
droop = cic.response(grid[passband] / cic.rate)
desired[passband] = droop[0] / droop  # 1 en continua, sube donde el CIC cae
Se congelan y no se rediseñan en cada ejecución por una razón concreta: son los coeficientes que se cargan en la IP, y si el modelo los recalculara, una actualización de SciPy movería el oráculo por debajo sin que nadie lo notara.
# GENERADO por tools/gen_coeffs.py. NO EDITAR A MANO.
# CIC: N=5 R=52 M=1
# FIR: taps=63 decim=4 coeff_bits=18
# Bandas (norm. a la fs de entrada del FIR): paso<=0.09 eliminada>=0.14 alias>=0.160
# Ganancia de continua entera: 552725
Resultado
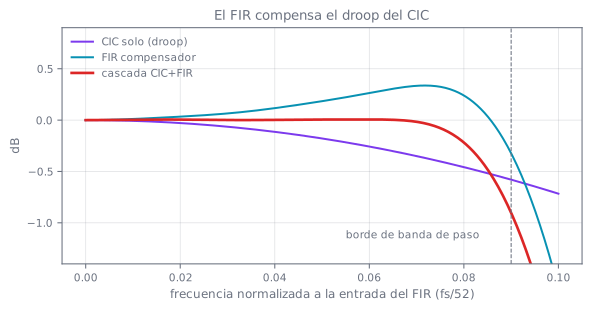
| Banda medida | CIC solo | Cascada CIC+FIR |
|---|---|---|
| 0 – 0,06 | 0,257 dB de caída | 0,006 dB de rizado |
| 0 – 0,09 (banda de paso completa) | 0,580 dB | 0,909 dB |
Y aquí va un resultado honesto que la gráfica enseña y conviene no maquillar: la compensación es excelente en los dos tercios interiores de la banda y empeora en el borde. En 0…0,06 el rizado baja de 0,257 dB a 0,006 dB, un factor 40. Pero al llegar a 0,09 el compensador sobrepasa y la cascada tiene más rizado que el CIC solo.
Es una consecuencia directa del compromiso de diseño: 63 taps, una banda de transición estrecha y una ventana de Hamming. No es un bug, es un punto de diseño mejorable, y le toca a Z1 afinarlo contra el cierre de recursos real del FIR Compiler. El test de CI asevera el tramo bueno; este documento declara el malo.
El error de diseño que sí hubo, y cómo se encontró
La primera versión puso el borde de banda eliminada en 0,125 —Nyquist dividido por el factor de diezmado— porque parecía lo natural. Es incorrecto. Lo que hay que atenuar no es «todo lo que pase de Nyquist/4», sino lo que pliega encima de la banda de paso al diezmar, que empieza en
Con el borde en 0,125 y 63 taps, la transición era demasiado abrupta y el alias real quedaba en −23 dB. Moviendo el borde a 0,14 —más cerca de la banda de paso, con la transición terminada antes de que empiece a plegar— el mismo filtro da −58,7 dB:
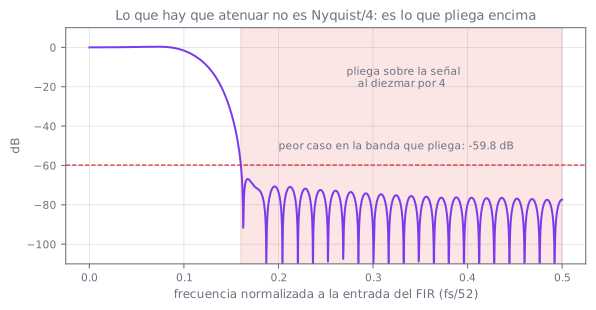
Lo encontró un test que asertaba la atenuación en la banda equivocada, se corrigió el test y con él el diseño. Es el argumento entero a favor de tener el modelo antes que el RTL: este error, descubierto en Z1 con la IP ya generada, habría costado una regeneración y un ciclo de síntesis.
Paso 5 — la etapa ÷2 del modo grueso
El modo de celda grande añade un semibanda de 23 taps. Sus números medidos:
| Métrica | Valor |
|---|---|
| Atenuación en la banda que pliega (≥0,35) | −69,4 dB |
| Rizado de banda de paso (0…0,15) | 1,20 dB |
El rizado de 1,2 dB es alto y está anotado como tal en el propio fichero de coeficientes: aceptable para Z0, lo afina Z1. El modo grueso se queda con la mitad del ancho de banda del fino, y esa es la contrapartida de la celda del doble de tamaño.
La cadena completa
def _decimate(self, branch):
    out = self.cic.process(branch)
    out = fixed.shift_round(out, self.cic.growth_bits)
    out = self.fir.process(out)
    out = fixed.shift_round(out, fixed.growth_bits(abs(self.fir.dc_gain)))
    if self.mode == MODE_COARSE:
        out = self.halfband.process(out)
        out = fixed.shift_round(out, fixed.growth_bits(abs(self.halfband.dc_gain)))
    # Ganancia unidad exacta: un multiplicador fino (`fixed.gain_trim`) deshace
    # lo que el redondeo de potencia de dos de arriba deja a medias.
    out = fixed.shift_round(out * self._gain_coeff, self._gain_frac_bits)
    return out
Un tono en el IF entra por la izquierda; sale una I/Q compleja en continua a fs/208:
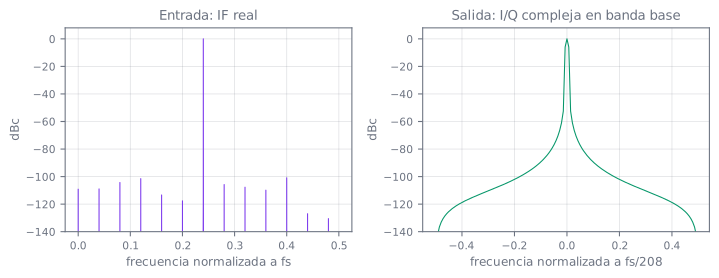
Medido sobre un tono de −3 dBFS y 60 000 muestras:
| Modo | R | Muestras de salida | |I+jQ| medio | Desviación relativa |
|---|---|---|---|---|
| fino | 208 | 288 | 11 599,0 | 0,00 |
| grueso | 416 | 144 | 11 597,0 | 0,00 |
Desviación exactamente cero: la amplitud de salida es constante bit a bit, que es lo que tiene que pasar cuando bajas un tono puro a continua con el NCO en la frecuencia exacta. Si hubiera un error de frecuencia residual, la fase giraría; si hubiera un error de escalado, la amplitud respiraría. Y ahora el fino y el grueso coinciden: ya no hay 6 dB de diferencia entre modos.
Sobre la ganancia neta
La entrada tiene pico 23 197 y la salida amplitud 11 599 — la mitad, casi exacta, y esa mitad es lo máximo alcanzable para un tono real puro: bajar una señal real a I/Q con un mezclador complejo reparte la energía entre la banda deseada y su imagen, así que un tono real a fondo de escala nunca puede dar más de la mitad de fondo de escala en banda base. Eso no es la pérdida que había que arreglar.
La pérdida que sí había que arreglar era otra: hasta el 7 de septiembre de 2026, cada punto de
recorte quitaba la ganancia de su etapa redondeando a la potencia de dos superior (growth_bits),
así que la cadena perdía varios dB encima de esa mitad inevitable, y el modo grueso perdía más que
el fino porque tiene una etapa de redondeo extra (el halfband). fixed.gain_trim calcula el
coeficiente entero exacto que hace falta multiplicar para deshacer ese redondeo — un único
multiplicador fino, en un único punto, igual que el resto de la cadena — y con eso CIC·FIR(·halfband)
quedan en ganancia unidad exacta: lo único que queda entre el fondo de escala de entrada y el de
salida es el factor de 2 inevitable del mezclador, no un redondeo de más. Con eso, «escalado de
ganancia y saturación con reporte de overflow» (Z1) está hecho para el modelo dorado — la bandera de
overflow de fixed.saturate ahora es significativa: la cadena de verdad usa el fondo de escala
disponible, así que una entrada realmente sobre-escala puede dispararla.
Paso 6 — el enrejado en rango
Después del diezmado, un bin de rango es exactamente una muestra: el promediado ya lo hizo la
cadena. Lo único que queda es trocear el flujo en rayos y marcar el último de cada uno con TLAST.
def gate(i, q, bins: int) -> list[Ray]:
    """Trocea en rayos de `bins` muestras.

    El último rayo puede quedar incompleto si el vector se acaba; se devuelve
    marcado como truncado en vez de descartarlo en silencio, porque un rayo corto
    en la placa es un fallo que el BITE tiene que ver.
    """
>>> np.flatnonzero(gating.tlast_mask(30, bins=10))   # posiciones de TLAST
array([ 9, 19, 29])
Conteo de bins por modo, desde el paquete de parámetros: 3689 en fino y 1844 en grueso.
Ese 1844 es el número de P-01
1844 bins de 249,41 m es la consecuencia aritmética de R₂ = 416, y son cuatro bins por encima del tope duro de 1840 de ORPG. No es un detalle del modelo: es el hallazgo abierto P-01, y por eso el conteo vive en el paquete de parámetros y no escrito dentro de un módulo.
La huella del oráculo
Un oráculo que cambia de valor sin que nadie lo decida no es un oráculo. Los tests fijan el SHA-256 de la salida del modelo para un vector conocido:
GOLDEN = {
    MODE_FINE: (192, "edf20575a4b82e3b96a2bd4333b60e0922e69cd1554ab7504154eb2aadcd6cca"),
    MODE_COARSE: (96, "d51dee4c0b61b30ea7a93dd6dd3aa5ca0d1c56e2f37b8979913d5ec4bef76feb"),
}
Si cambias un modo de redondeo, un coeficiente o un punto de recorte, este test falla. Eso es deliberado: obliga a justificar en el commit por qué cambió el oráculo, en lugar de que se mueva sin que nadie lo vea.
Los vectores de estímulo
model/drx_model/vectors.py genera lo que consumen por igual el modelo y el vector_source del RTL:
tono puro, dos tonos, barrido por toda la zona de Nyquist, impulso, escalón, y tono modulado con
desbalance I/Q. Más las degradaciones: ruido gaussiano a un SNR dado, offset de continua y entrada
sobre-escala.
Dos decisiones que merecen explicación:
Todo se pide en frecuencia normalizada, nunca en Hz. Así un vector generado con los parámetros de la ZedBoard y otro con los de la ZU9 son la misma secuencia de enteros. Hay un test:
def test_los_vectores_son_identicos_en_las_dos_plataformas():
    """La consecuencia buscada de D-02: un vector, dos placas."""
    assert np.array_equal(vectors.tone(load("zedboard"), 2048),
                          vectors.tone(load("zu9"), 2048))
Toda función aleatoria exige semilla. Sin argumento por defecto:
def test_el_ruido_exige_semilla():
    with pytest.raises(TypeError):
        vectors.add_noise(vectors.tone(PARAMS, 128), 20.0, PARAMS)
Un oráculo que cambia entre ejecuciones no sirve para comparar bit a bit.
Y una nota de física que conviene no perder: el desbalance I/Q se inyecta en banda base, antes de subir al IF, porque es ahí donde lo introduce un frontal en cuadratura. Con muestreo de IF real el ADC no mete desbalance; entra por delante. Modelarlo en el sitio equivocado daría una robustez falsa.
Anterior: 2 · Aritmética de punto fijo · Siguiente: 4 · Simulación